Khi Monitoring nói dối
Có lúc Dashboard báo Uptime thấp, nhưng khi kiểm tra lại thiết bị và log thì không thấy downtime tương ứng. Khi đó câu hỏi không còn là “thiết bị có down không?” mà là “mình đang đo nó bằng cách nào?”.

Trong một đợt Capacity Assessment mà mình tham gia năm 2025, team phải đánh giá nhiều thành phần Network qua CPU, RAM, Bandwidth, Uptime, tình trạng thiết bị và khả năng đáp ứng trong những năm tiếp theo.
Monitoring data là nguồn rất quan trọng. Nếu không có historical data, mình rất dễ rơi vào kiểu đánh giá bằng cảm giác: “đường này chắc vẫn ổn”, “switch này chưa thấy ai complain”, hay “CPU có vẻ thấp”.
Nhưng trong dữ liệu lúc đó có một chuyện khá thú vị. Một số thiết bị Core, Distribution và Firewall có Uptime trên Monitoring thấp hơn kỳ vọng. Nếu chỉ nhìn Dashboard, kết luận khá tự nhiên sẽ là: hệ thống từng bị downtime.
Khi kiểm tra sâu hơn thì không đơn giản như vậy. Có giai đoạn một số sensor mất kết nối với probe hoặc trả trạng thái Unknown. Điều này kéo số liệu Uptime xuống dù thiết bị vẫn hoạt động. Team phải đối chiếu thêm firewall log, switch log và các nguồn quan sát khác để xác nhận không có downtime thực tương ứng.
Mình nhớ tình huống này vì nó nhắc một điều rất cơ bản: Monitoring cũng là một hệ thống, và nó cũng có thể sai.
Dashboard chỉ là một lớp trung gian
Một graph đại diện cho traffic. Một percentage đại diện cho CPU. Màu xanh đại diện Healthy. Màu đỏ đại diện Incident. Nhưng tất cả những thứ đó đều đi qua một chuỗi thu thập và xử lý trước khi xuất hiện trên màn hình.

Một device không trả SNMP có thể nghĩa là device chết. Nhưng cũng có thể SNMP service lỗi, ACL thay đổi, collector mất route, firewall chặn, Monitoring server quá tải hoặc sensor bị stuck.
Nhiều nguyên nhân khác nhau có thể tạo ra cùng một trạng thái Unknown. Vì vậy mình ngày càng ít xem một con số trên Dashboard như kết luận cuối cùng.
Khi số liệu không khớp thực tế, mình đi tìm nguồn thứ hai
Khi Uptime không khớp với những gì team quan sát trong thực tế, cách xử lý không phải sửa số liệu cho đẹp. Cách hợp lý hơn là tìm thêm bằng chứng độc lập.
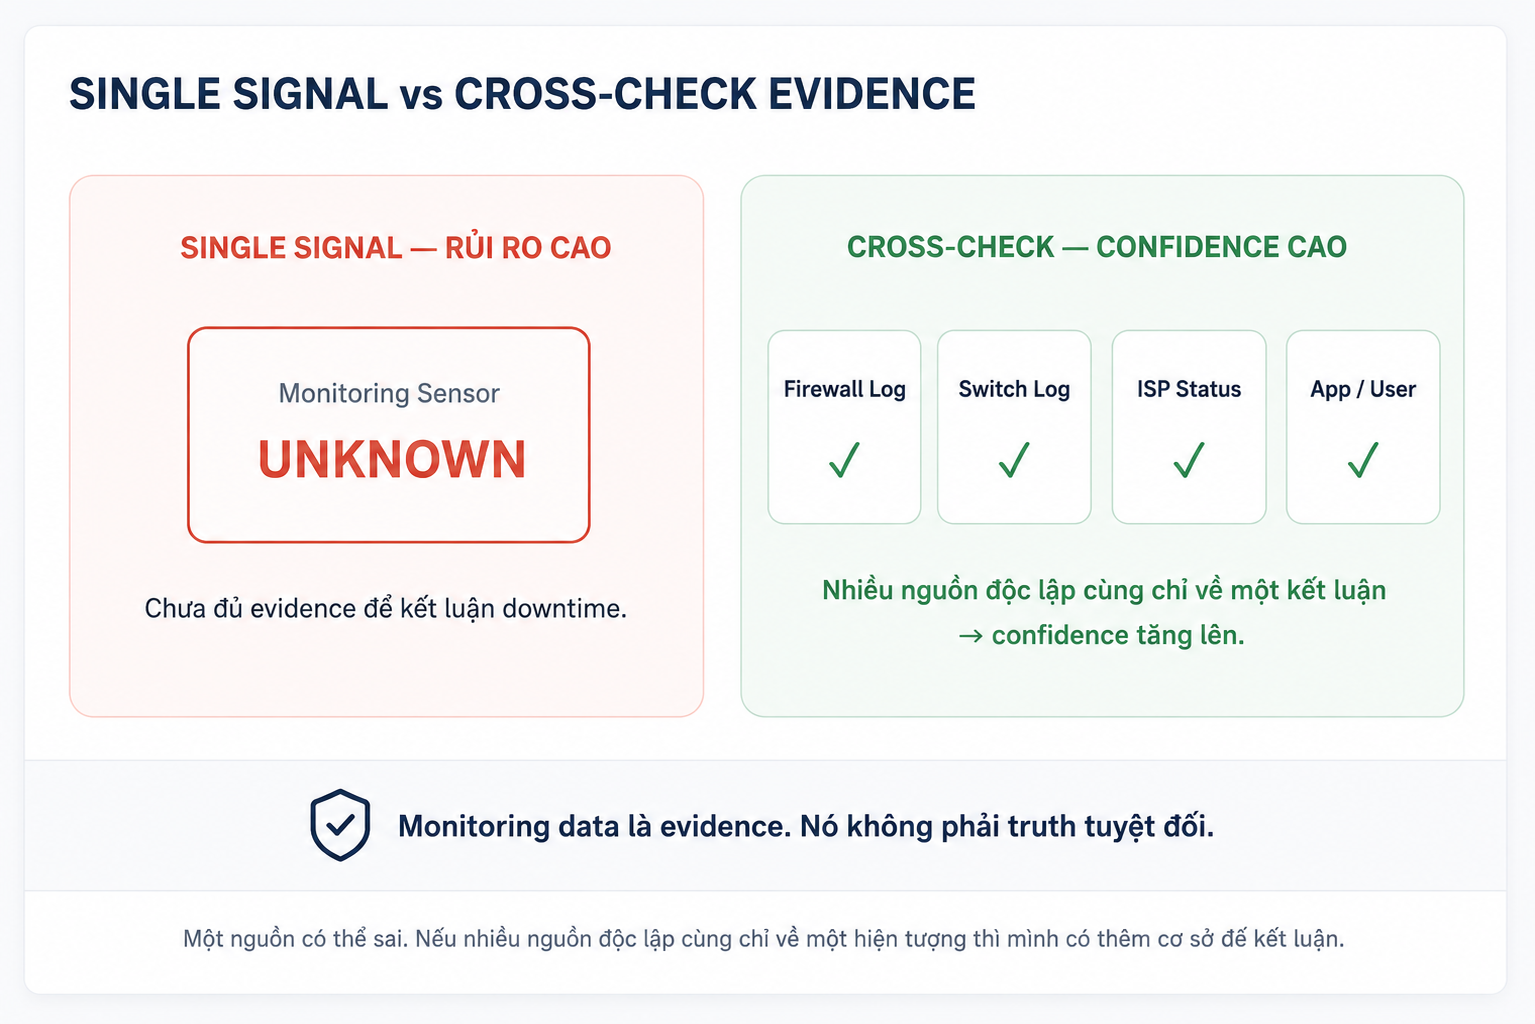
Firewall log có ghi interface flap không? Switch log có reload hay mất adjacency không? ISP có ghi nhận outage không? User hoặc application có cùng thời điểm gián đoạn không?
Đó là lý do mình thích centralized view để xem nhanh, nhưng vẫn muốn giữ khả năng đi xuống nguồn gốc của dữ liệu khi cần kiểm tra lại.
Threshold cũng cần context
Trong cùng đợt đánh giá có thời điểm international bandwidth tăng rất cao do các đợt data transfer lớn lên cloud và hoạt động backup tập trung. Team phải điều phối lại thời gian truyền dữ liệu và làm việc với ISP trong thời gian cao điểm.
Signal là thật, nhưng bản thân con số chưa nói hết câu chuyện. Traffic 80% có thể là congestion, cũng có thể là migration đã được lên kế hoạch. CPU cao có thể là incident, cũng có thể là batch job đúng thiết kế.

Vì vậy threshold chỉ là điểm bắt đầu. Sau Alert vẫn cần người vận hành hiểu chuyện gì đang xảy ra.
Thiết bị chạy nhàn vẫn có thể cần thay
Capacity Assessment cũng cho mình một bài học khác. Nhiều thiết bị có CPU và RAM trung bình khá thấp. Nếu chỉ nhìn performance thì chúng vẫn còn dư.

Nhưng khi đưa EOS/EOL, security patch, hardware replacement và vendor support vào bức tranh thì câu chuyện thay đổi. Một thiết bị có thể CPU thấp, RAM ổn, traffic thấp — và vẫn là một rủi ro vận hành vì đã đi quá xa trong vòng đời sản phẩm.
“Còn chạy được” và “còn phù hợp để tiếp tục phụ thuộc” không phải lúc nào cũng là một.
Sau lần đó, mình nhìn Monitoring khác đi một chút
Mục tiêu của Monitoring tất nhiên vẫn là phát hiện vấn đề sớm. Nhưng với mình, còn thêm hai câu hỏi nữa: tín hiệu này được tạo ra như thế nào, và mình có nguồn nào để kiểm tra lại khi nó không khớp với thực tế?
Một con số rất chính xác vẫn có thể được tạo ra từ một measurement path đang có vấn đề.
Dashboard giúp mình bắt đầu điều tra. Nó không thay thế việc kiểm chứng.
Ghi lại từ những trải nghiệm thực tế của mình trong quá trình làm Infrastructure — những câu chuyện vẫn còn tiếp tục.
Đọc trước ← Xây dựng Enterprise NOC thực dụng