Nhắc đến migration, mình thường nhớ đến một tối cuối tuần: Change Request đã approve, engineer và vendor đều online, checklist mở sẵn và mọi người bắt đầu nhìn đồng hồ.
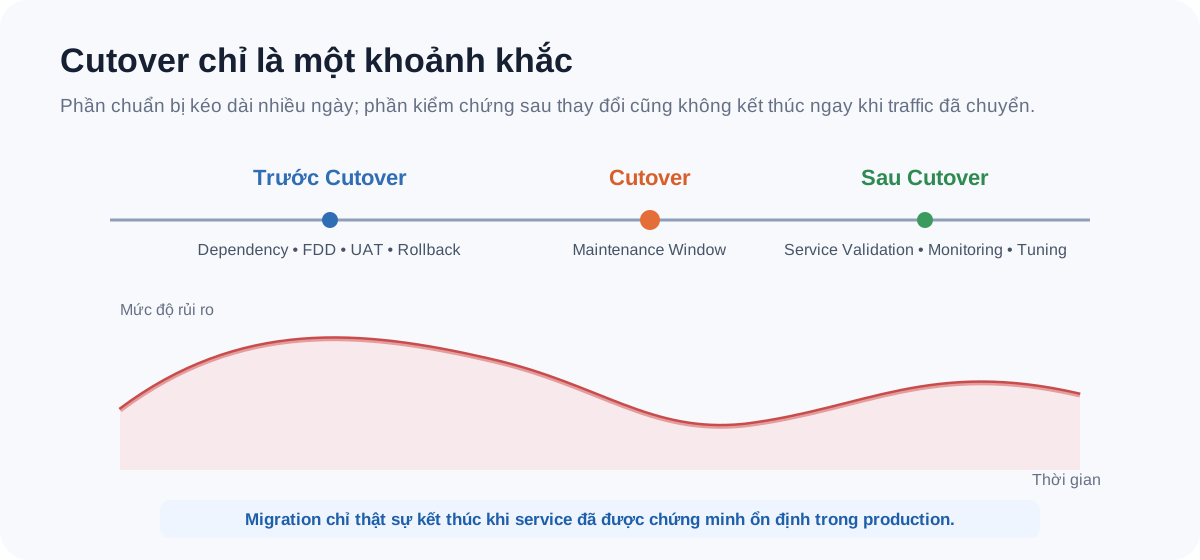
Nhưng sau nhiều lần tham gia và lead các thay đổi Infrastructure, mình thấy cutover chỉ là phần dễ nhìn thấy nhất. Một migration tốt thường đã được chuẩn bị từ nhiều ngày, thậm chí nhiều tuần trước đó.
Không phải lúc bắt đầu gõ command, mà từ lúc team ngồi lại để hiểu hệ thống đang phụ thuộc vào điều gì, điều gì tuyệt đối không được mất, và mình sẽ dùng bằng chứng nào để nói rằng thay đổi đã thành công.
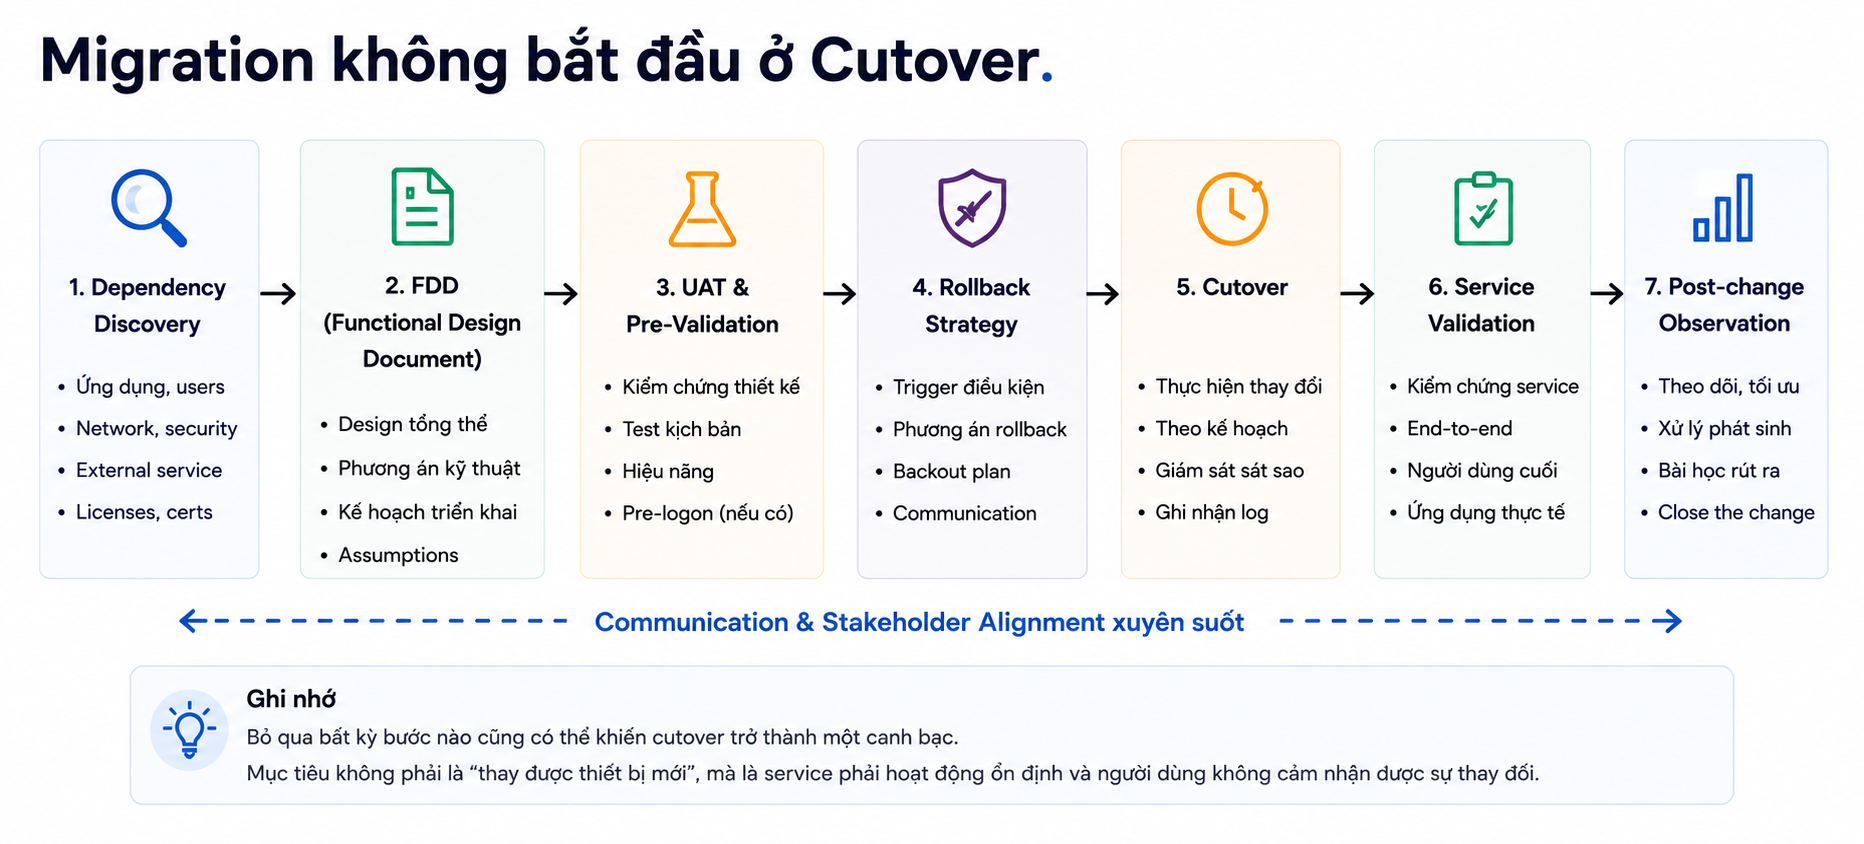
Thiết bị cũ và thiết bị mới chỉ là hai đầu của câu chuyện
Khi thay một platform, câu hỏi dễ nhất thường là: cấu hình cũ sẽ chuyển sang thiết bị mới như thế nào?
Nhưng configuration mapping chỉ là một phần. Một firewall còn có routing, NAT, VPN, authentication, logging, HA và những application phía sau. Một Load Balancer có virtual service, health check, persistence, certificate. Một IPS đặt inline lại có thêm câu hỏi rất thực tế: nếu policy mới chặn nhầm thì flow nào sẽ bị ảnh hưởng?
Vì vậy trước cutover, mình thường muốn hiểu traffic path và dependency trước. Không phải để có một diagram đẹp, mà để biết khi một thứ thay đổi thì mình cần nhìn ở đâu.
Migration không chỉ là chuyển configuration từ A sang B. Quan trọng hơn là thay một phần của hệ thống mà service phía sau vẫn làm việc như trước.
FDD hữu ích nhất ở lúc mình phải nghĩ trước
Trong một số project mình từng lead, FDD là chỗ architecture, configuration logic, migration sequence và các assumption được đặt cạnh nhau. Giá trị của nó không nằm ở số trang.
Giá trị nằm ở những câu hỏi xuất hiện trong lúc viết: interface nào thực sự đang carrying traffic? Route nào static, route nào học động? HA sẽ chuyển role ra sao? Có dependency nào đi qua một policy tưởng như không liên quan? Nếu rollback thì trạng thái nào phải phục hồi trước?
Nhiều vấn đề nếu thấy ở FDD chỉ là một dòng cần sửa. Nếu thấy giữa maintenance window, nó có thể trở thành một incident.
UAT nên được viết trước khi biết kết quả
Mình thích xác định UAT trước cutover, vì lúc đó success criteria chưa bị ảnh hưởng bởi tâm lý muốn kết thúc maintenance cho xong.
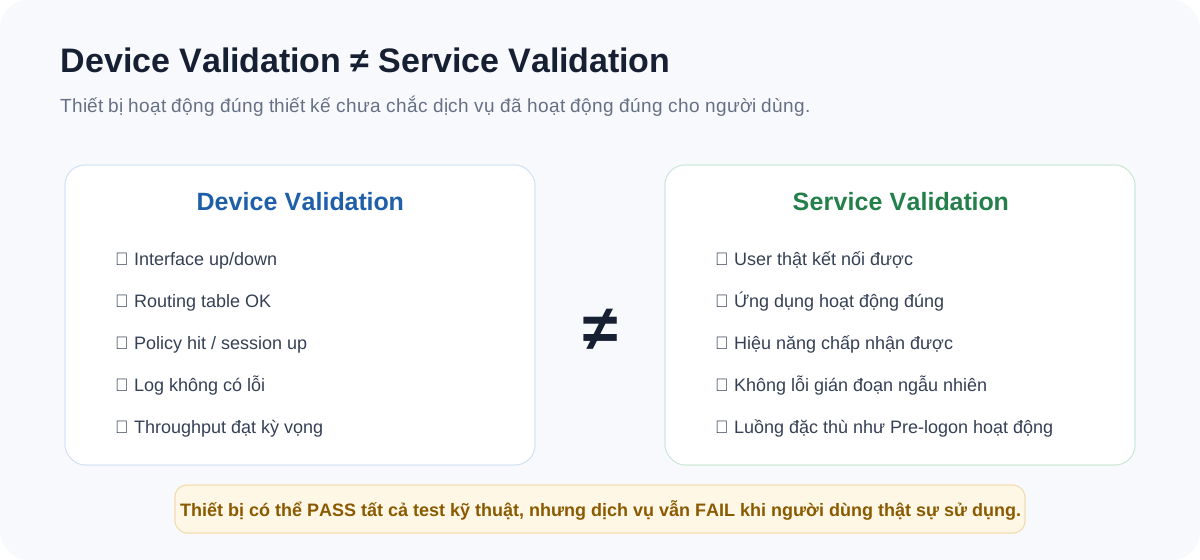
Ở project External Firewall migration từ Palo Alto PA-3050 sang PA-3410 tại THP, validation không chỉ là HA đã hình thành hay policy đã migrate. Checklist còn đi qua public application, IPSec VPN, SSL Decryption, reporting và GlobalProtect VPN Pre-logon cho laptop công ty.
Pre-logon là một ví dụ mình nhớ khá lâu. Từ phía firewall, migration có thể nhìn hoàn toàn “xanh”. Nhưng một laptop ở ngoài văn phòng vẫn cần tự hình thành VPN về Head Office trước khi user làm việc bình thường theo policy. Nếu flow đó không nằm trong checklist, lỗi có thể chỉ xuất hiện nhiều giờ sau khi maintenance window đã đóng.
Đó là lúc mình thấy rõ sự khác nhau giữa device validation và service validation.
Rollback nên được quyết định trước khi có áp lực
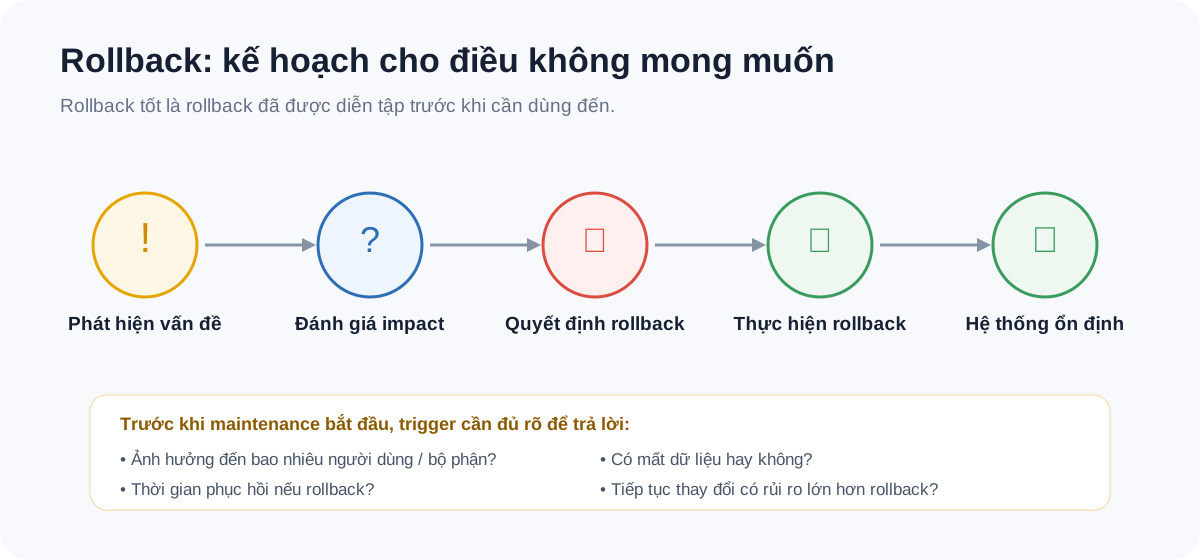
Có một nghịch lý nhỏ: càng tự tin vào migration, người ta càng dễ xem rollback như phần phụ. Nhưng với mình, một rollback plan rõ ràng lại giúp team tự tin hơn khi quyết định đi tiếp.
Rollback cần trả lời ba chuyện rất cụ thể: khi nào quay lại, quay lại bằng cách nào, và sau khi quay lại thì kiểm tra trạng thái cũ đã thực sự ổn bằng gì.
Phần khó nhất thường là rollback trigger. Nếu không chốt trước, khi maintenance kéo dài, team rất dễ rơi vào trạng thái “thử thêm một chút nữa”. Mỗi thay đổi tiếp theo lại làm trạng thái hệ thống xa baseline hơn và đường quay lại khó hơn.
Mình không xem rollback là dấu hiệu của một migration thất bại. Nó đơn giản là một nhánh đã được chuẩn bị sẵn của change.
Đến Cutover, phần lớn câu hỏi lớn nên đã có câu trả lời
Khi maintenance window bắt đầu, mình muốn mọi người đã biết ai làm bước nào, ai quan sát, vendor phụ trách phần nào, khi nào pause, khi nào validate và khi nào rollback.
Production vẫn có thể đưa ra những dependency mà tài liệu không thể hiện hết. Nhưng chuẩn bị tốt giúp team phân biệt đâu là expected behavior, đâu là anomaly và đâu là tín hiệu cần dừng.
Trong các migration như Peplink, Palo Alto, FortiGate hay IPS mà mình từng tham gia, công nghệ khác nhau nhưng sequence mình thường giữ khá giống nhau:
Baseline → Change → Technical Validation → Service Validation → Observe → Close hoặc Rollback.
Traffic đã chuyển chưa có nghĩa migration đã xong
Thời điểm traffic chạy qua platform mới thường tạo cảm giác đã đến đích. Thực tế, đó mới là lúc bắt đầu một giai đoạn khác.
Monitoring sau thay đổi giúp nhìn ra những thứ UAT ngắn chưa chắc thể hiện: error tăng chậm, session behavior bất thường, một flow ít dùng, performance khác baseline hoặc dependency chỉ xuất hiện theo lịch business.
Với Security Infrastructure, chuyện này càng rõ. Khi triển khai IPS, đưa thiết bị inline chưa phải điểm kết thúc. Observation, policy tuning và quá trình đi từ Detection đến Prevention mới cho biết control đó có phù hợp với production hay không.
Điều mình giữ lại sau nhiều maintenance window
Ngày trước khi nhìn một migration plan, mình chú ý nhiều đến phần execution: bao nhiêu bước, command nào, sequence ra sao và mất bao lâu.
Những thứ đó vẫn quan trọng. Nhưng càng làm lâu, mình càng dành nhiều thời gian hơn cho những câu hỏi xảy ra trước và sau execution.
Dependency nào mình chưa thấy? Success được định nghĩa bằng device status hay bằng service? Nếu phải quay lại, điểm quay lại an toàn nhất ở đâu? Và sau tất cả, bằng chứng nào cho thấy hệ thống thực sự ổn?
Những migration mình nhớ nhất không phải vì cutover kéo dài bao lâu. Mình nhớ cách cả team chuẩn bị để khi maintenance window bắt đầu, chúng mình không phải vừa thay đổi hệ thống vừa tìm hiểu xem hệ thống đang hoạt động như thế nào.
Cutover là một thời điểm. Migration là cả một quá trình.
Ghi lại từ những trải nghiệm thực tế của mình trong quá trình làm Infrastructure — những câu chuyện vẫn còn tiếp tục.
Đọc tiếp theo chủ đề: Một vài dấu mốc Infrastructure 2023–2026 · High Availability không bắt đầu từ thiết bị thứ hai · Resilience không chỉ là Uptime · Hệ thống vẫn chạy tốt, tại sao vẫn phải thay?