Khi Data Center không còn là đáp án: từ DC Proposal đến Infrastructure Consolidation
Một case thực tế về Capacity Planning, TCO, Proxmox/PBS và cách target cuối cùng thay đổi trước khi đi vào production.
Có những project bắt đầu bằng một câu hỏi kỹ thuật nhưng kết thúc bằng một phương án khác hẳn giả định ban đầu.
Project này là một trường hợp như vậy.
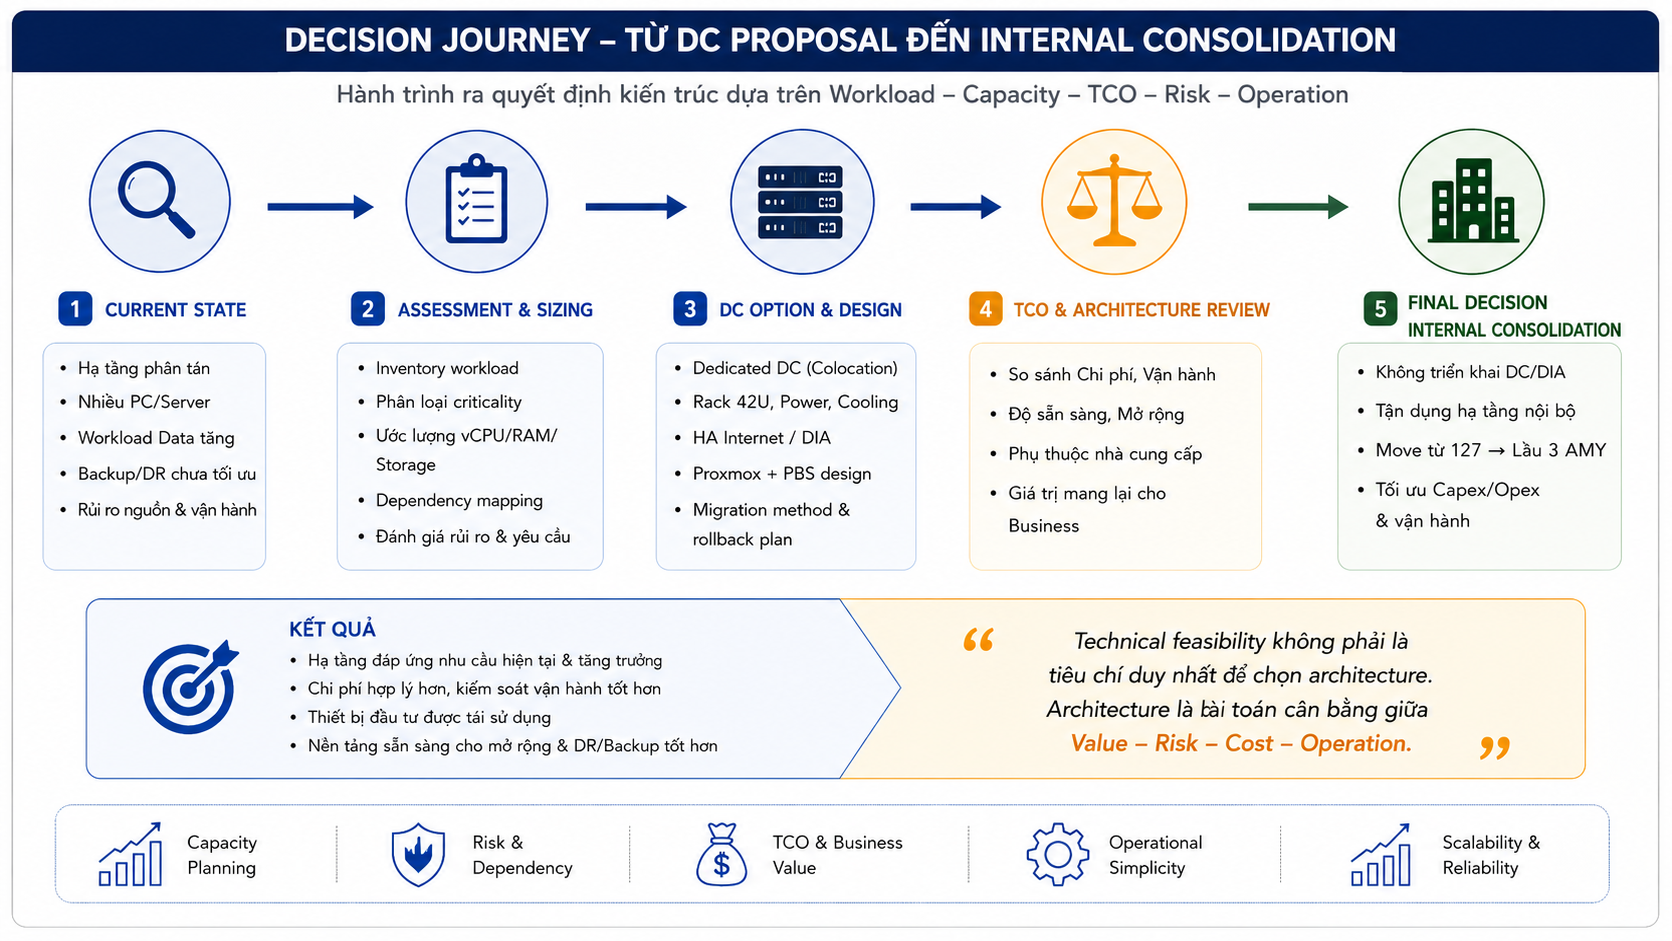
Ở thời điểm bắt đầu, bài toán khá rõ: hạ tầng hiện hữu cần được xem lại về capacity, khả năng mở rộng, backup/recovery và rủi ro vận hành. Một số workload đang chạy trên virtualization, một số workload khác vẫn phụ thuộc vào các máy vật lý riêng lẻ. Storage tiếp tục tăng, dependency giữa Data platform, network và backup ngày càng nhiều hơn, trong khi location hiện hữu không còn phù hợp cho giai đoạn tiếp theo.
Phương án đầu tiên là đưa workload sang một external Data Center với dedicated infrastructure, network connectivity và một migration plan được chuẩn bị khá sâu.
Nhưng càng đi vào sizing, commercial scope và cách hệ thống sẽ được vận hành sau migration, câu hỏi quan trọng nhất lại thay đổi.
Đó là lúc project không còn chỉ là bài toán relocation.
Bắt đầu từ workload, không bắt đầu từ catalog phần cứng
Điều đầu tiên mình không muốn làm là chọn server trước rồi cố gắng nhét workload vào cấu hình đã chọn.
Với một platform có nhiều thành phần như database, Airflow, Spark, Kafka, MinIO, ingestion/processing workers và các service phụ trợ khác, cách làm hợp lý hơn là đi ngược từ workload.
Mỗi workload cần trả lời một vài câu hỏi rất cơ bản:
Đây cũng là lúc những máy vật lý đang đóng vai trò worker được xem lại. Nếu một workload có thể chạy tốt dưới dạng VM và không có dependency đặc biệt với phần cứng, việc tiếp tục duy trì một PC vật lý riêng cho nó không nhất thiết còn hợp lý.
Một migration vì thế cũng là dịp để hỏi lại:
Workload nào nên move nguyên trạng? Workload nào nên rebuild? Workload nào nên consolidate? Và workload nào không còn lý do để tiếp tục tồn tại theo cách cũ?
External Data Center là một phương án đã được chuẩn bị thật
Phương án external Data Center đã được chuẩn bị ở mức đủ sâu để có thể triển khai nếu được chọn.
Thiết kế ban đầu bao gồm dedicated infrastructure, rack, network connectivity, public addressing, monitoring/support và migration method. Commercial scope cũng đã được làm việc đến mức có hợp đồng và phụ lục liên quan đến thiết bị, Data Center service và đường truyền.
Điều này quan trọng vì quyết định cuối cùng không đến từ việc “chưa kịp làm DC”. Phương án external DC đã được đánh giá nghiêm túc về khả năng triển khai.
Technical feasibility
Capacity có thể đáp ứng, dedicated infrastructure có thể triển khai, network và migration path có thể thiết kế, rollback có thể chuẩn bị.
Điều còn phải cân
TCO, recurring cost, độ phức tạp khi vận hành, khả năng tận dụng phần đầu tư hiện có và mức độ phù hợp với nhu cầu thực tế.
Bài học mình giữ lại khá rõ từ project này là: một phương án triển khai được chưa chắc đã là phương án nên chọn.
Ba lựa chọn, ba cách trả lời khác nhau cho cùng một nhu cầu
Trong quá trình assessment, các lựa chọn được đặt cạnh nhau theo hướng purchase, lease-to-buy và dedicated infrastructure/service. Purchase cho ownership rõ ràng nhưng đưa CapEx lên sớm; lease-to-buy trải chi phí theo thời gian; còn dedicated/colocation giảm một phần gánh nặng facility nhưng tạo recurring cost và dependency với external provider/network.
Khi thêm rack, power, cooling, DIA, support, remote hands, recurring fee và khả năng tái sử dụng hạ tầng hiện có vào bài toán CPU/RAM/storage, bức tranh TCO bắt đầu khác đáng kể.
Khi target thay đổi
Sau khi cân lại cost/value, phương án cuối cùng không tiếp tục theo hướng đặt toàn bộ target platform ở external Data Center.
Phần Data Center recurring service và DIA không đi vào production. Thay vào đó, phần hardware investment còn phù hợp được giữ lại và target location chuyển về một internal server room tại site mới.
Architecture thay đổi, nhưng phần công việc đã làm trước đó không biến mất.
Workload inventory vẫn còn giá trị. Capacity assessment vẫn còn giá trị. Proxmox sizing vẫn còn giá trị. PBS migration strategy, network segmentation, rollback, physical move plan và cutover checklist vẫn còn giá trị.
Thứ thay đổi chủ yếu là target location và cách hệ thống sẽ được vận hành.
Đặt các trade-off cạnh nhau
Để nhìn quyết định này rõ hơn, mình tách một số tiêu chí ra để so sánh. Bảng dưới đây dùng đánh giá định tính vì mục tiêu của bài là nói về cách cân nhắc, không phải công bố số liệu thương mại nội bộ.
| Decision criteria | External Data Center | Internal Consolidation |
|---|---|---|
| Upfront infrastructure investment | Medium | Higher |
| Recurring facility / service cost | Higher | Lower |
| Dedicated connectivity dependency | Higher | Lower |
| Facility resilience | Strong by design | Requires internal engineering |
| Physical security | Strong | Site-dependent |
| Operational control | Shared / provider-dependent | High |
| Existing hardware reuse | Moderate | High |
| Internal power & cooling responsibility | Lower | Higher |
| Long-term flexibility | Medium | High |
| Overall fit for this project | Technically viable | Selected architecture |
Phương án không được chọn không có nghĩa là phương án kém. External DC mạnh hơn ở facility resilience và giảm bớt một số trách nhiệm vật lý; internal consolidation lại cho quyền kiểm soát cao hơn, tận dụng tốt hơn phần investment đã có và giảm một số recurring dependency.
TCO không chỉ là giá mua server
Khi cân TCO, mình không chỉ nhìn hardware acquisition.
Các cost driver cần đặt cùng nhau gồm CapEx cho infrastructure, recurring facility/service fee, DIA/connectivity, power & cooling, support/remote hands, vận hành và khả năng tái sử dụng asset hiện hữu. Một phương án có initial cost thấp hơn chưa chắc có chi phí thấp hơn trong vài năm vận hành; chiều ngược lại cũng vậy.
Từ “move DC” thành Infrastructure Consolidation
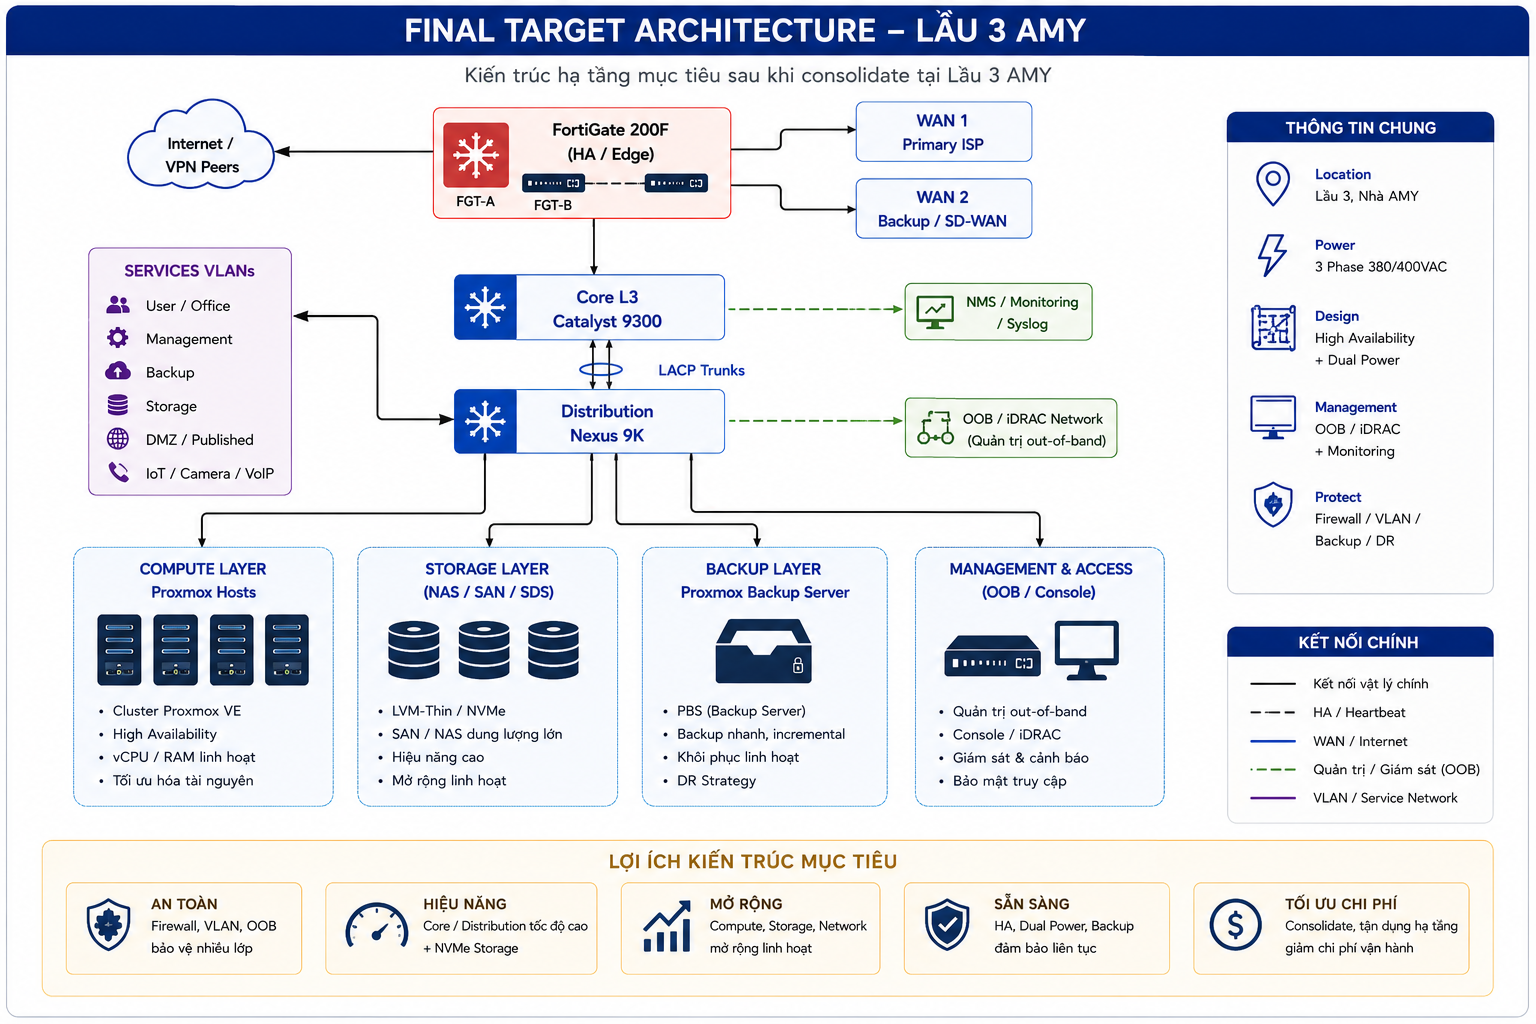
Khi target chuyển về internal server room, project không còn đơn thuần là Data Center relocation. Phạm vi thực tế trở thành:
Physical site migration + network redesign + compute consolidation + storage/backup integration + service validation.
Ở tầng network, target được tổ chức lại theo các lớp rõ ràng hơn: firewall/edge, Layer-3 core, distribution cho server farm, compute, storage và management.
Physical port mapping, rack layout, uplink và LACP được document trước khi cutover. Việc này nghe có vẻ nhỏ, nhưng trong một maintenance window có nhiều thiết bị, một port mapping không rõ ràng có thể biến thành hàng chục phút troubleshooting không cần thiết.
Mình giữ một nguyên tắc khá đơn giản:
Nếu một kết nối quan trọng chỉ tồn tại trong trí nhớ của một người, đến lúc cutover nó rất dễ trở thành điểm mù của cả team.
Proxmox không chỉ là nơi đặt VM
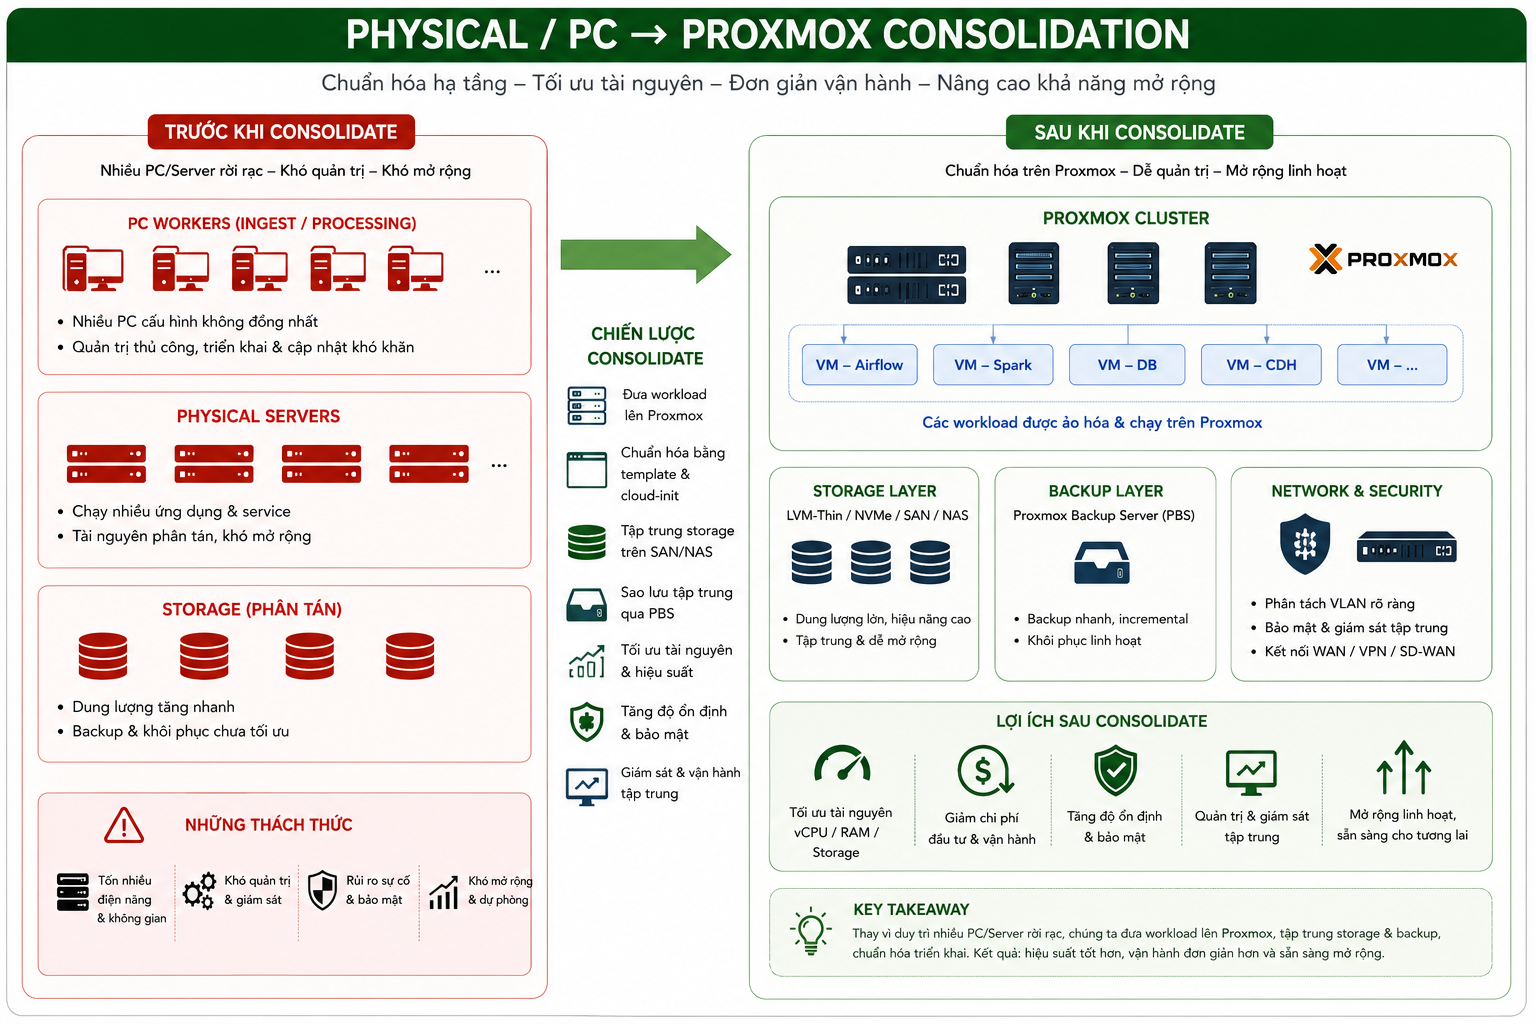
Một phần quan trọng của consolidation là đưa nhiều workload về một virtualization platform có thể quản lý, backup và khôi phục nhất quán hơn.
Trong project này, đi cùng Proxmox VE còn có storage design, PBS, template, Cloud-Init, network bridge, SSH access và cách chuẩn hóa VM provisioning.
Với workload cần giữ state, migration strategy phù hợp hơn là giữ nguyên dữ liệu và trạng thái qua backup/restore:
Full backup/seed → incremental delta → validate restore → workload freeze → final sync → restore → service validation.
Với workload stateless hoặc có thể dựng lại sạch, cách tiếp cận khác hiệu quả hơn:
Golden template → clone → Cloud-Init → network/SSH baseline → application/data sync.
Hai cách này trả lời hai loại workload khác nhau.
Backup chỉ có ý nghĩa khi restore path tồn tại
PBS trở thành một phần quan trọng không chỉ vì cần một bản backup trước khi move.
Trong một physical migration, backup còn tạo ra một recovery path độc lập với thiết bị đang được di chuyển. Nếu một host gặp vấn đề sau transport, nếu storage không activate như kỳ vọng hoặc nếu VM không lên đúng trạng thái, team vẫn cần một điểm quay lại đã được kiểm chứng.
Điều mình quan tâm không phải chỉ là trạng thái “Backup: Successful”. Những câu hỏi quan trọng hơn là:
Restore ở đâu? Restore mất bao lâu? Storage target đã sẵn sàng chưa? Network mapping sau restore là gì? Và service nào phải được kiểm tra trước khi nói VM đã phục hồi?
Đó là lý do restore validation nên nằm ngay trong kế hoạch migration, không phải để đến lúc có vấn đề mới thử.
Đừng tạo RTO/RPO chỉ để bài trông có số liệu
RTO/RPO là những chỉ số hữu ích, nhưng chỉ có ý nghĩa khi chúng thực sự được định nghĩa, gắn với workload và được kiểm chứng. Trong project này mình không có cơ sở đủ chắc để công bố một formal target kiểu “RTO = X giờ” hay “RPO = Y phút”, nên mình không thêm các con số đó vào.
Thay vào đó, migration được chuẩn bị theo hướng giảm data exposure bằng incremental/final synchronization trước cutover, giữ PBS như một recovery path độc lập, xác nhận storage/network target và chỉ xem recovery hoàn tất sau khi service-level validation đạt yêu cầu.
Data exposure
Giảm bằng incremental delta và final synchronization trước khi workload được cutover.
Recovery path
PBS backup/restore, target storage/network readiness và service validation tạo thành đường quay lại đã được chuẩn bị.
Nếu sau này một workload có formal RTO/RPO, restore testing mới là nơi chứng minh objective đó có khả thi hay không. Với project này, điều có thể nói chắc hơn là: backup success không được dùng thay cho recovery evidence.
Power cũng là dependency của Infrastructure
Khi target chuyển về internal server room, một phần công việc không còn nằm thuần trong network hay virtualization. Nguồn điện, phân tải, UPS và cooling cũng trở thành dependency trực tiếp của platform.
Thay vì cố kéo runtime UPS thật dài, thiết kế thực tế tập trung vào việc phân tải nguồn 3 pha hợp lý, tận dụng dual PSU của thiết bị và dùng UPS như một bridge ngắn hạn. Khi mất điện lưới, UPS giữ critical IT load trong khoảng chuyển tiếp ngắn để máy phát điện khởi động và ổn định; generator mới là nguồn dự phòng dài hạn.
Với thiết bị dual-power, hai PSU không nên bị xem như hai dây nguồn giống nhau. Một feed đi qua UPS-backed power, feed còn lại đi theo utility/generator path giúp giảm single point of failure và linh hoạt hơn khi bảo trì.
Physical Move là lúc mọi dependency gặp nhau
Asset move plan cho project được tách theo nhóm thiết bị, priority và bring-up sequence.
Trước khi move, cần biết thiết bị nào phải shutdown trước, thiết bị nào phụ thuộc storage, thiết bị nào phải lên trước để network có thể phục hồi, và thiết bị nào có thể để sau vì không nằm trên critical path.
Sequence thực tế vì vậy không phải:
“Đem hết qua chỗ mới rồi bật lên.”
Nó gần hơn với:
Backup → label → shutdown → transport → rack/power → core/distribution → firewall/WAN → storage → compute → management/OOB → service validation.
Chính thứ tự này giúp tránh một kiểu troubleshooting khá quen: application chưa lên nhưng team lại đang kiểm tra Layer 7 trong khi storage hoặc routing bên dưới vẫn chưa sẵn sàng.
Infrastructure Green vẫn chưa đủ
Đây là điểm project này nối khá tự nhiên với nhiều migration khác mình từng làm.
Một Core Switch có thể UP. LACP có thể bundled. Firewall có thể healthy. WAN có thể reachable. Proxmox node có thể online.
Nhưng những trạng thái đó chỉ cho biết từng component đang hoạt động.
Chúng chưa chứng minh business service đã trở lại.
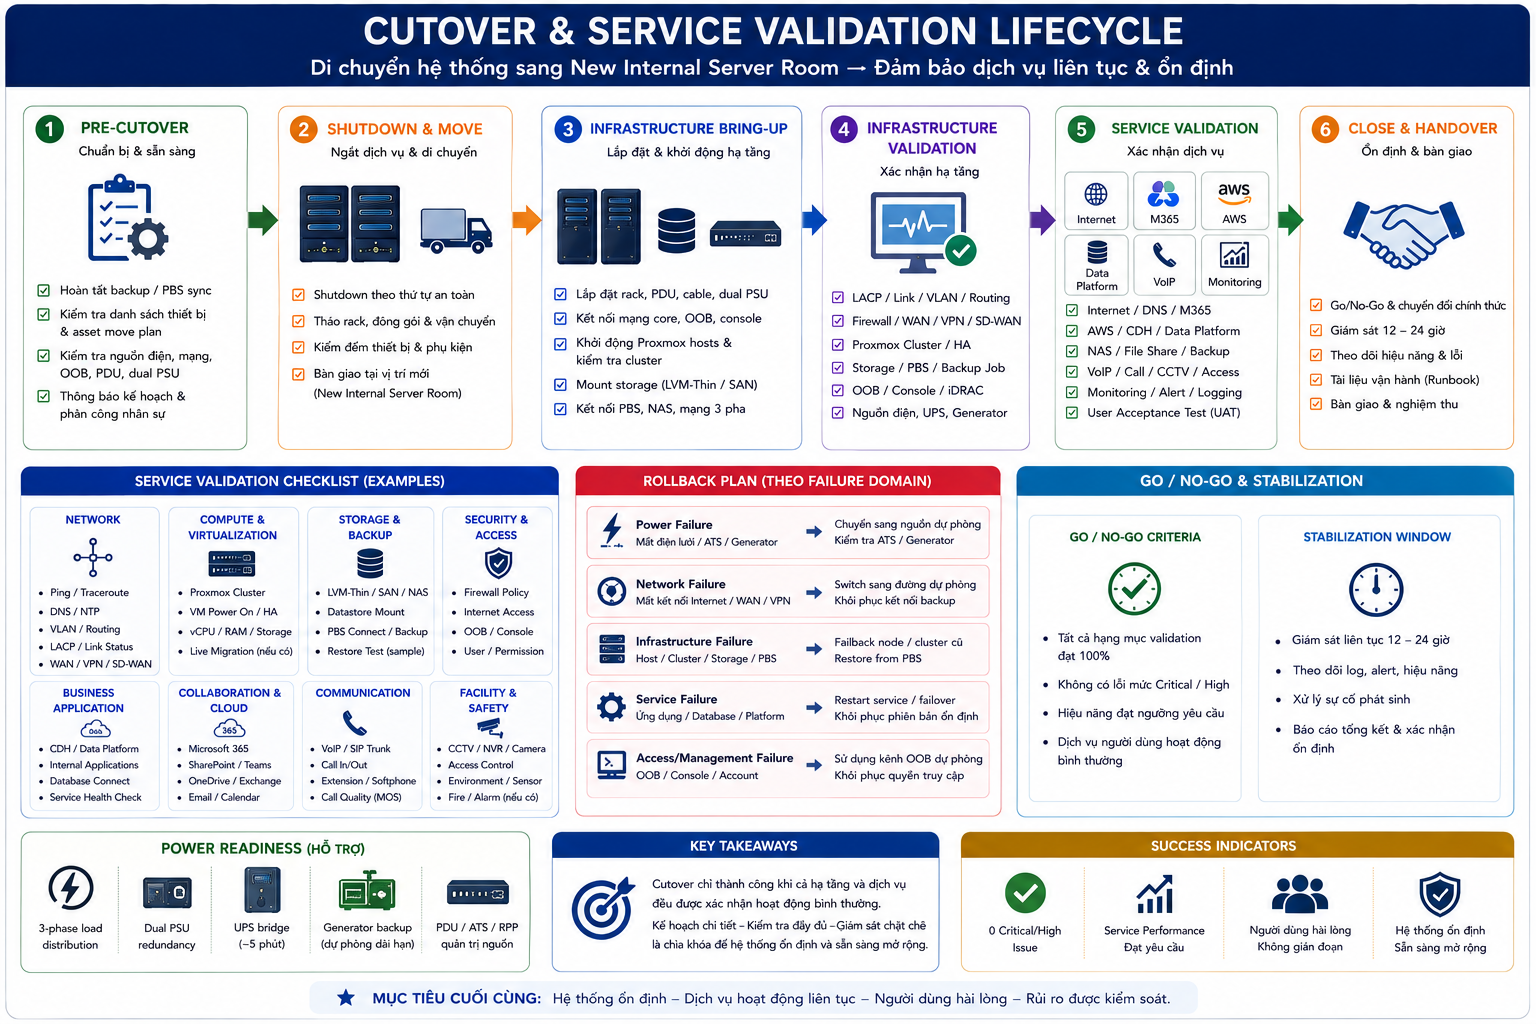
Vì vậy cutover checklist được tách thành hai nhóm kiểm tra:
Infrastructure Validation
Physical links, Core/Distribution, LACP, routing, firewall transit, WAN/SD-WAN, VPN, storage connectivity, Proxmox node health.
Service Validation
Internet, Microsoft 365, AWS connectivity, VM/workload, Data platform, NAS/backup, published services, VoIP, CCTV/FaceID và monitoring.
Migration chỉ có thể đóng khi service phía trên đã được kiểm tra, không phải chỉ vì từng thiết bị phía dưới đều xanh.
Rollback phải được nghĩ khi mọi thứ còn đang bình thường
Rollback trong project này cũng không được xem như một nút “Undo”.
Mỗi failure domain cần một recovery path riêng.
Nếu LACP giữa core và distribution không lên, team phải biết kiểm tra member, cabling, configuration và khi nào cần fallback sang standalone uplink. Nếu WAN có vấn đề, cần phân biệt lỗi physical/ISP với routing/SD-WAN. Nếu VPN không lên, underlay phải được xác nhận trước khi mất thời gian với tunnel. Nếu OOB chưa sẵn sàng, phải biết console/local recovery path nằm ở đâu.
Rollback không nên được nghĩ ra khi migration bắt đầu thất bại. Nó phải tồn tại trước khi thiết bị đầu tiên được shutdown.
Sau cutover mới thấy platform có dễ vận hành hay không
Đóng maintenance window không có nghĩa project đã kết thúc.
Sau move còn phải kiểm tra storage activation, chuẩn hóa VM provisioning, cập nhật SSH key, validate network settings, kiểm tra backup job, baseline monitoring và làm sạch những temporary workaround đã dùng trong cutover.
Trong phần Proxmox, mình còn giữ lại một SOP nhỏ cho việc clone Ubuntu VM từ golden template bằng qm clone và Cloud-Init. Script được dùng để giữ baseline nhất quán, provisioning nhanh hơn và phục vụ workload ingest/migration mà không phải dựng tay từng VM.
Những note troubleshooting như validate sshd, xử lý host key, set network từ Proxmox host hay recover LVM khi PV còn nhưng VG chưa active có vẻ rất nhỏ khi đứng riêng lẻ.
Nhưng chính những việc nhỏ đó quyết định sau này team support platform có thuận lợi hay không.
Một diagram đẹp không giúp nhiều nếu platform khó provision, khó troubleshoot và chỉ một vài người biết cách phục hồi.
Điều đáng nhớ nhất không phải là việc Data Center đã không được chọn
External DC không phải một phương án sai. Nó giải quyết tốt một số vấn đề về facility, physical security, power, cooling và support. Nhưng khi đặt cạnh workload profile, hardware investment, recurring cost, network dependency và cách team thực tế sẽ vận hành hệ thống, một phương án khác phù hợp hơn ở thời điểm đó.
Điều quan trọng không nằm ở việc chọn “DC” hay “on-prem”, mà nằm ở việc team có đủ dữ liệu để biết tại sao mình chọn.
Nhìn lại project
Project đi từ workload inventory và capacity assessment đến external DC design, TCO review, rồi chuyển thành physical migration, network redesign, Proxmox/PBS consolidation, backup/restore, power readiness và cutover.
Điều mình giữ lại không phải tên server, model switch hay số lượng VM. Mình nhớ cách câu hỏi thay đổi: ban đầu là “Hạ tầng cần bao nhiêu CPU, RAM và storage?”; sau đó là “Phương án nào đáp ứng capacity và availability?”; và cuối cùng là “Phương án nào đủ tốt nhưng vẫn phù hợp với chi phí và cách team sẽ vận hành nó hằng ngày?”
Đó cũng là lý do mình thích những project kiểu này. Kết quả cuối không nhất thiết giống proposal ban đầu, miễn là quyết định sau cùng dựa trên nhiều thông tin hơn.
Công nghệ chỉ là một phần. Sau cùng vẫn phải trả lời được hệ thống sẽ chạy ở đâu, phục hồi thế nào, ai sẽ vận hành và chi phí đó có hợp lý hay không.
Ghi lại từ những trải nghiệm thực tế của mình trong quá trình làm Infrastructure — những câu chuyện vẫn còn tiếp tục.
Đọc thêm ← Migration không bắt đầu ở CutoverĐọc tiếp → Resilience không chỉ là Uptime